-
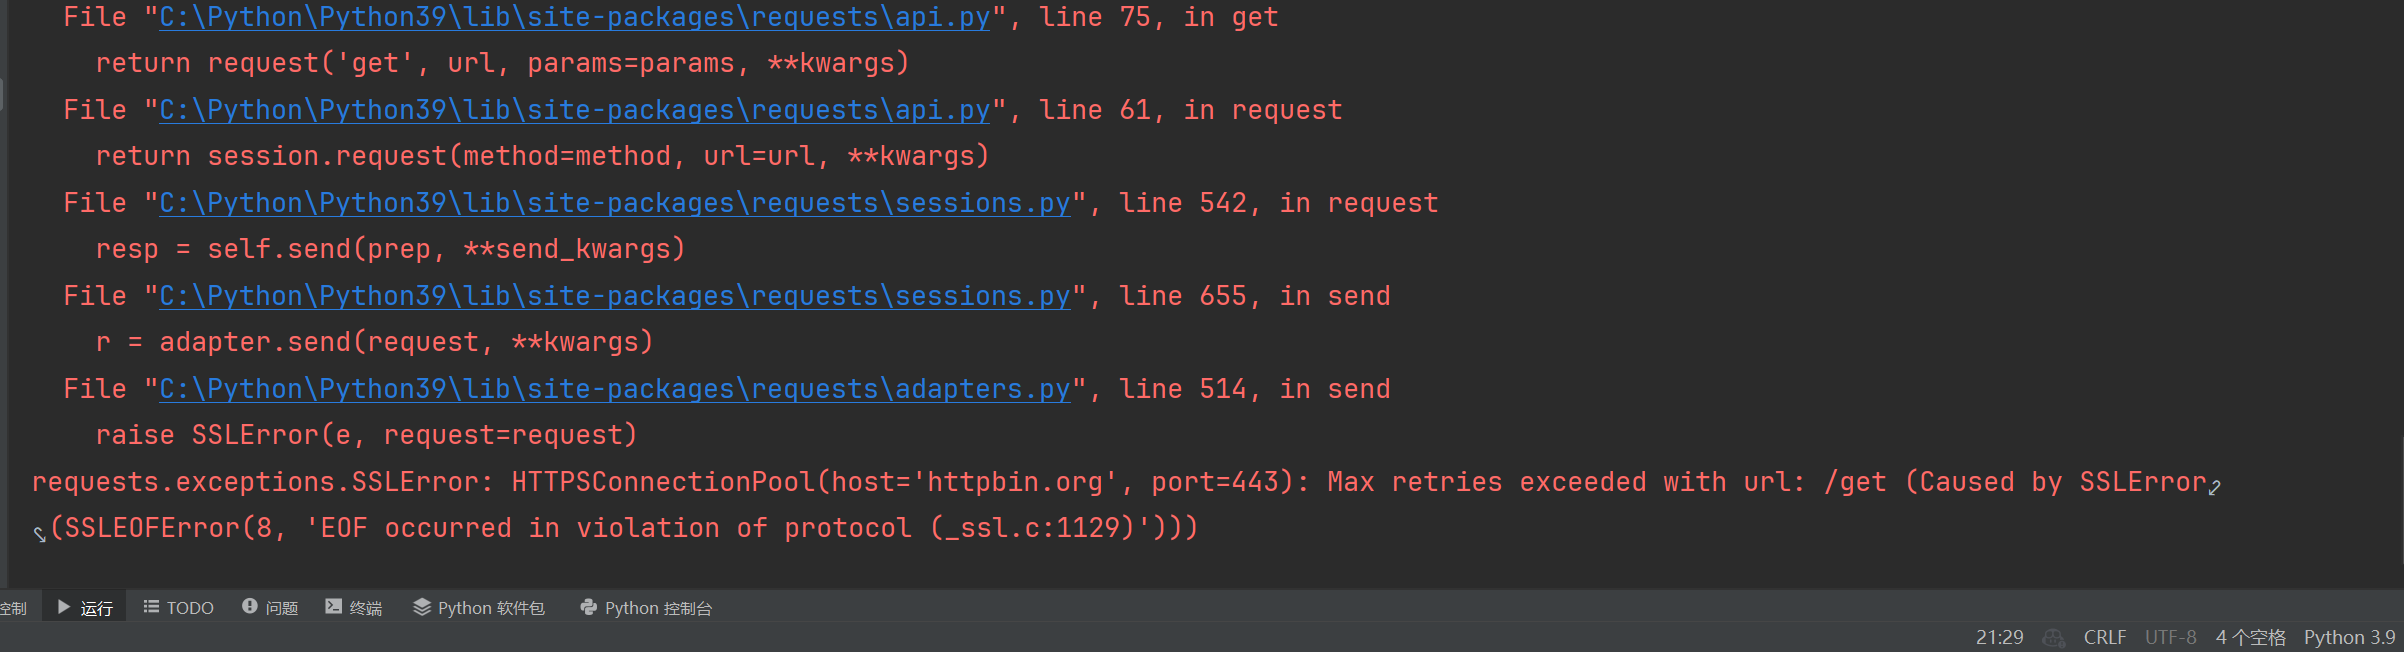
Python爬虫报错:(Caused by SSLError(SSLEOFError(8, ‘EOF occurred in violation of protocol (_ssl.c:1129)’)))解决
今天在写爬虫的时候遇到一个错误,即: requests.exceptions.SSLError: HTTPSConnectionPool(host='httpbin.org', port=443): Max retries exceeded with url: /get (Caused by SSLError(SSLEOFError(8, 'EOF occurred …... 塵風
- 0
- 0
- 18k
-
Python从列表中随机获取元素方法
Python从列表中随机获取元素方法:可以使用python中random模块的sample, choice, choices,randint方法来进行。下面我们一起来看下四种从列表中随机获取元素方法: sample random.sample(sequence, k) sample的作用是从指定序列中随机获取指定长度的片断并随机排列,结果以列表的形式返回。 注意:sample函数不会修改原有序列(…...- 塵風
- 0
- 0
- 6.1k
-
Python拼接URL:urllib.parse urljoin使用
Python拼接URL可以使用urllib.parse中的urljoin方法,urllib是Python中一个用于URL 处理的模块,urllib.parse 用于解析 URL,在之前分享的Python从路径|URL中获取文件名、文件后缀的方法中提到过使用其中的urlparse方法解析URL,感兴趣的可以去看看。 urllib.parse模块的的urlparse和urljoin刚好是两个相反的功能…...- 塵風
- 0
- 0
- 1.5k
-
Python从路径|URL中获取文件名、文件后缀的方法
Python从路径|URL中获取文件名、文件后缀的方法分享: 我们可以通过urlparse模块中的urllib.parse方法、os.path模块或者是字符串split、rfind等方法去实现,非常简单。这样就不用去写正则了哈哈哈。 一般情况下urlparse更合适解析URL(URL中有参数的时候,不需要做其他处理),os.path模块则更合适处理本地路径,所以大部分时候个人建议选择这两种方式也就…...- 塵風
- 0
- 0
- 1.7k
-
Python获取两个列表的交集
python获取两个列表的交集方法分享:记录了三个Python获取两个列表的交集的方法,它们分别使用:列表转集合、for循环、列表推导式配合lambda函数实现,具体的示例代码如下: 方法一 列表转集合 推荐 集合操作符& 将两个列表转换为set集合,然后使用集合操作符&求解两个set集合的交集 # -*- coding: utf-8 -*- list1 = ['…...- 塵風
- 0
- 0
- 1.2k
-
下载1个资源
 下载1个资源
百度已收录404链接自动提取软件+使用教程-免费
软件介绍 现在有非常多的网站被黑然后搜索被搜索引擎收录了色情赌博一类的垃圾信息,我们站点被黑处理完成后把这些垃圾信息链接设置为404就需要对这些已经收录的链接进行提取,然后提交到百度资源平台删除,但是对于大部分没有技术基础的小伙伴来说,都只能一个个手动去复制,这样太过于麻烦了,所有开发了这个软件分享给大家。 关于处理流程的教程,我之前也分享了相关文章,如果你有需要,也可以查看: 网站被黑,被搜索引…...- 塵風
- 0
- 6
- 1.6k
-
python Queue(进程队列)
在Python中我知道队列模块有: from queue import Queue此模块适用于线程间通信,但不能用于进程间通信。from multiprocessing import Queue此模块用于对进程,但是不能用于进程池。 下面笔记记录的就是:from multiprocessing import Queue 用于进程间通信的队列。 部分内容来源以及相关资料: Python 队列(Que…...- 塵風
- 0
- 0
- 1.2k
-
python转换Unix时间戳
python 转换Unix时间戳可以使用python中的time模块和datetime模块 time # -*- coding: utf-8 -*- import time # new_date = time.ctime(Unix时间戳) new_date = time.ctime(1567764428) print(new_date) # Fri Sep 6 18:07:08 2019 date…...- 塵風
- 0
- 0
- 1.8k
-
Python requests 异常Proxy URL had no scheme, should start with http:// or https://解决
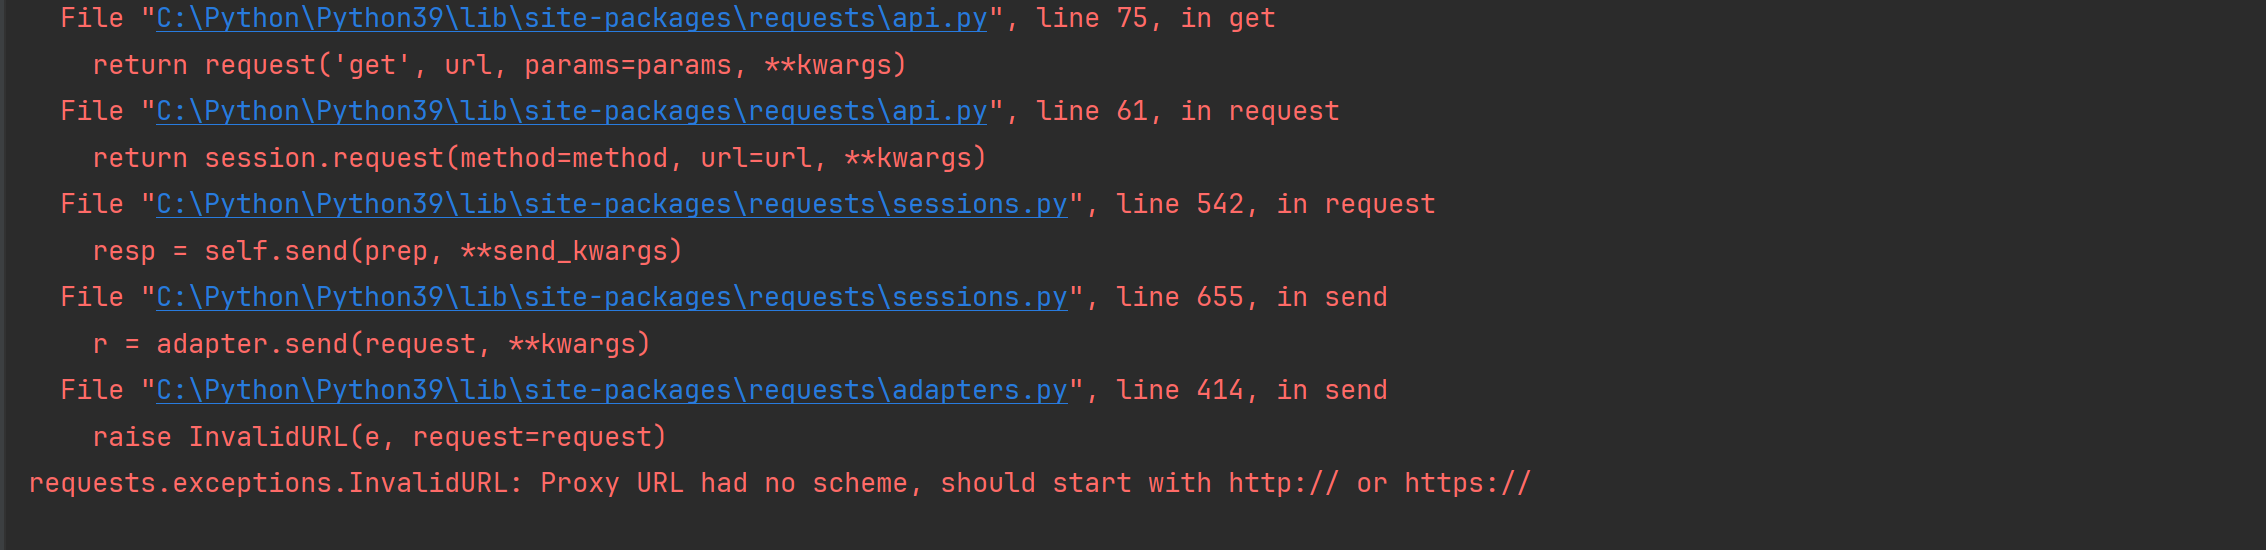
异常原因 Python requests 异常Proxy URL had no scheme, should start with http:// or https://解决,在使用Python requests的proxy代理功能的时候出现了这个错误,意思是我们使用的代理方案应该以http:// or https://开头。 在网上看到的原因是说在Python3.7及以上版本中使用request…...- 塵風
- 0
- 0
- 1.3k
-
网站搜索页面出现大量垃圾网页被收录怎么处理
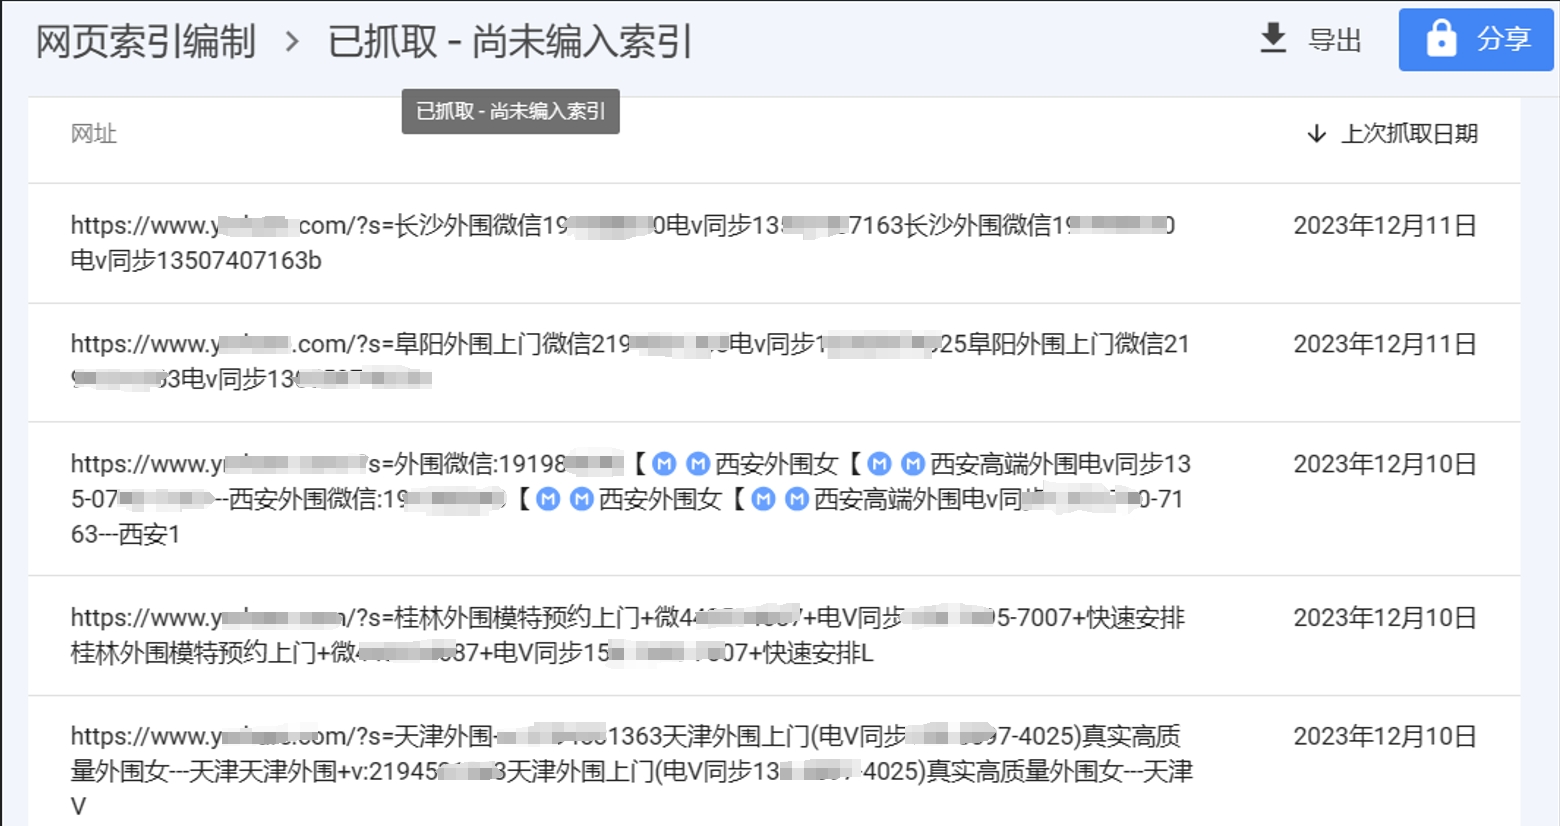
网站搜索页面出现大量垃圾网页被收录怎么处理?这个问题是前几天一个朋友问我的,问题示例如下: 问题展示 再说解决方法之前我们先聊聊这个问题出现的原因,原因很明显: 就是网站被模拟搜索了大量的垃圾信息关键词,然后出现了对应的页面让搜索引擎抓取了。 像这种也算是"黑帽SEO"推广了吧...不过我认为这个东西实现起来还是很简单的,技术含量很低,而且挺早之前就出现了。 我可不可以不处理?…...- 塵風
- 0
- 0
- 2k
-
Python爬虫requests参数timeout以及retrying的使用
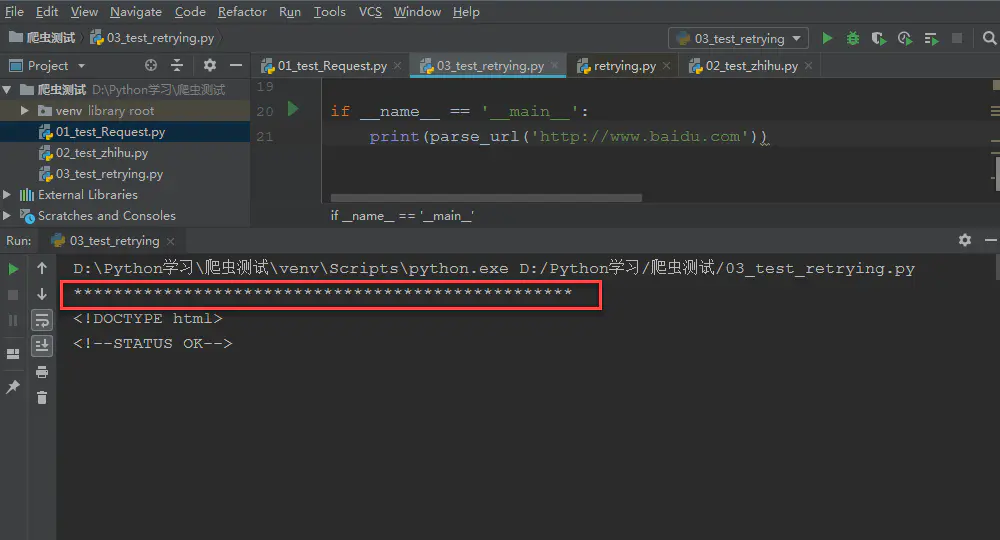
timeout参数的使用 在某些网络情况不好或者服务器端异常的情况会出现请求慢或者请求异常的情况,这个时候我们需要给请求设置一个超时时间,而不是让程序一直在等待结果。写一个简单的例子: import .requests response = requests.get('https://www.linfengnet.com/', timeout=3) print(response…...- 塵風
- 0
- 0
- 1.5k
-
Python os.walk() 方法
概述 os.walk() 方法用于通过在目录树中游走输出在目录中的文件名,向上或者向下。 os.walk() 方法是一个简单易用的文件、目录遍历器,可以帮助我们高效的处理文件、目录方面的事情。 在Unix,Windows中有效。 语法 walk()方法语法格式如下: os.walk(top[, topdown=True[, onerror=None[, followlinks=False]]]) …...- 塵風
- 0
- 0
- 1.2k
-
Python模块requests参数verify – SSL证书认证
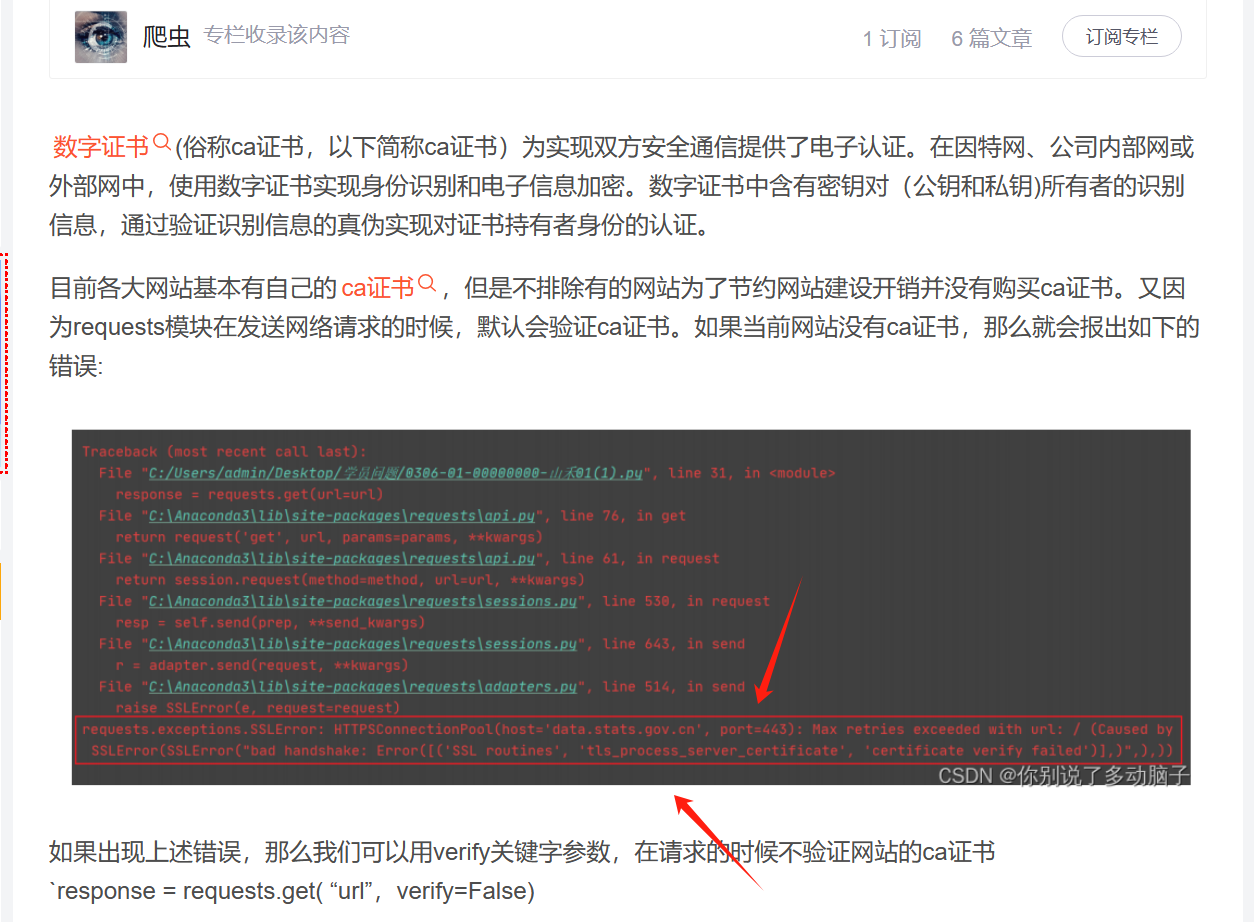
Python模块requests参数verify - SSL证书认证 requests模块中verify关键词参数用于控制是否开启SSL证书认证,requests在请求HTTPS链接时,默认是开启SSL证书认证的,即请求中verify参数默认为True(verify=True)。 关闭SSL证书认证 如果要关闭SSL证书认证,我们可以把verify参数设置False即可,例如: # -*- cod…...- 塵風
- 0
- 0
- 1.4k
-
Python获取字典的前x个元素
Python获取字典的前*个元素我们可以使用itertools中的islice函数实现或者是sorted函数、Counter(dict).most_common()函数实现,再Python中列表实现这样的需求就很简单,我们可以直接通过切片获取,不过字典没有切片,我们就先取出所有 keys,再用拿到的key去取value,在组成一个新的字典就可以了。 注意: sorted函数、Counter(dic…...- 塵風
- 0
- 0
- 1.4k
-
python os.scandir()函数
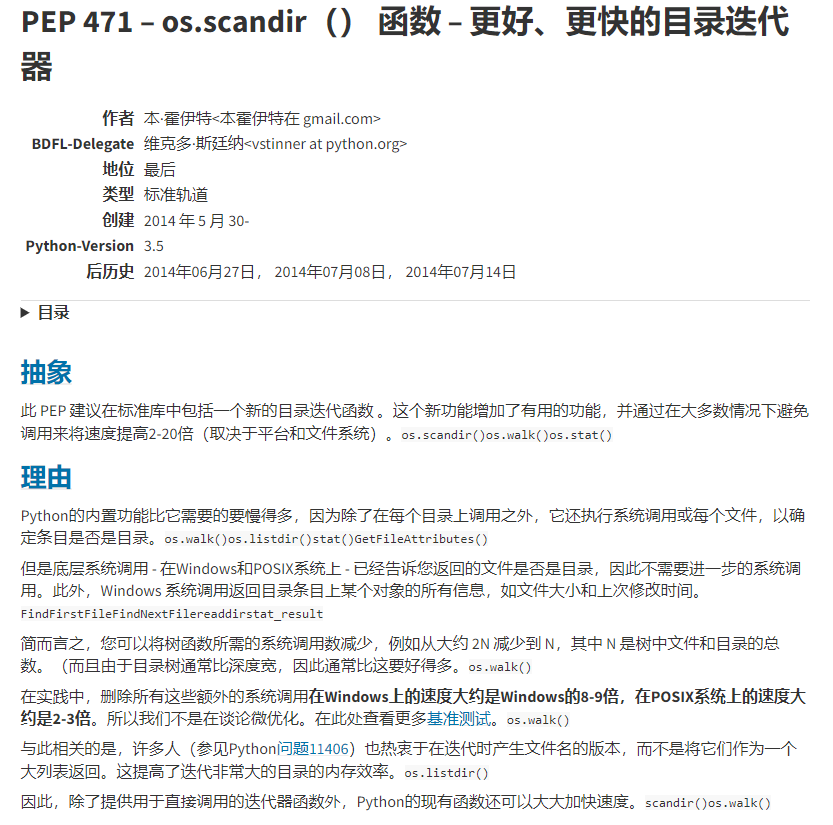
概述 在 Python 3.5版本中,新添加了 os.scandir()方法, scandir是一个目录迭代方法,返回一个DirEntry迭代器对象,它能告诉你迭代文件的路径。 os.scandir() 的运行效率要比 os.walk 高。 在 PEP 471 中,Python 官方也推荐我们使用 os.scandir() 来遍历目录。 相关文章:Python os.walk() 方法 官方介绍截…...- 塵風
- 0
- 0
- 2.1k
-
网站被黑,被搜索引擎收录垃圾信息删除处理教程
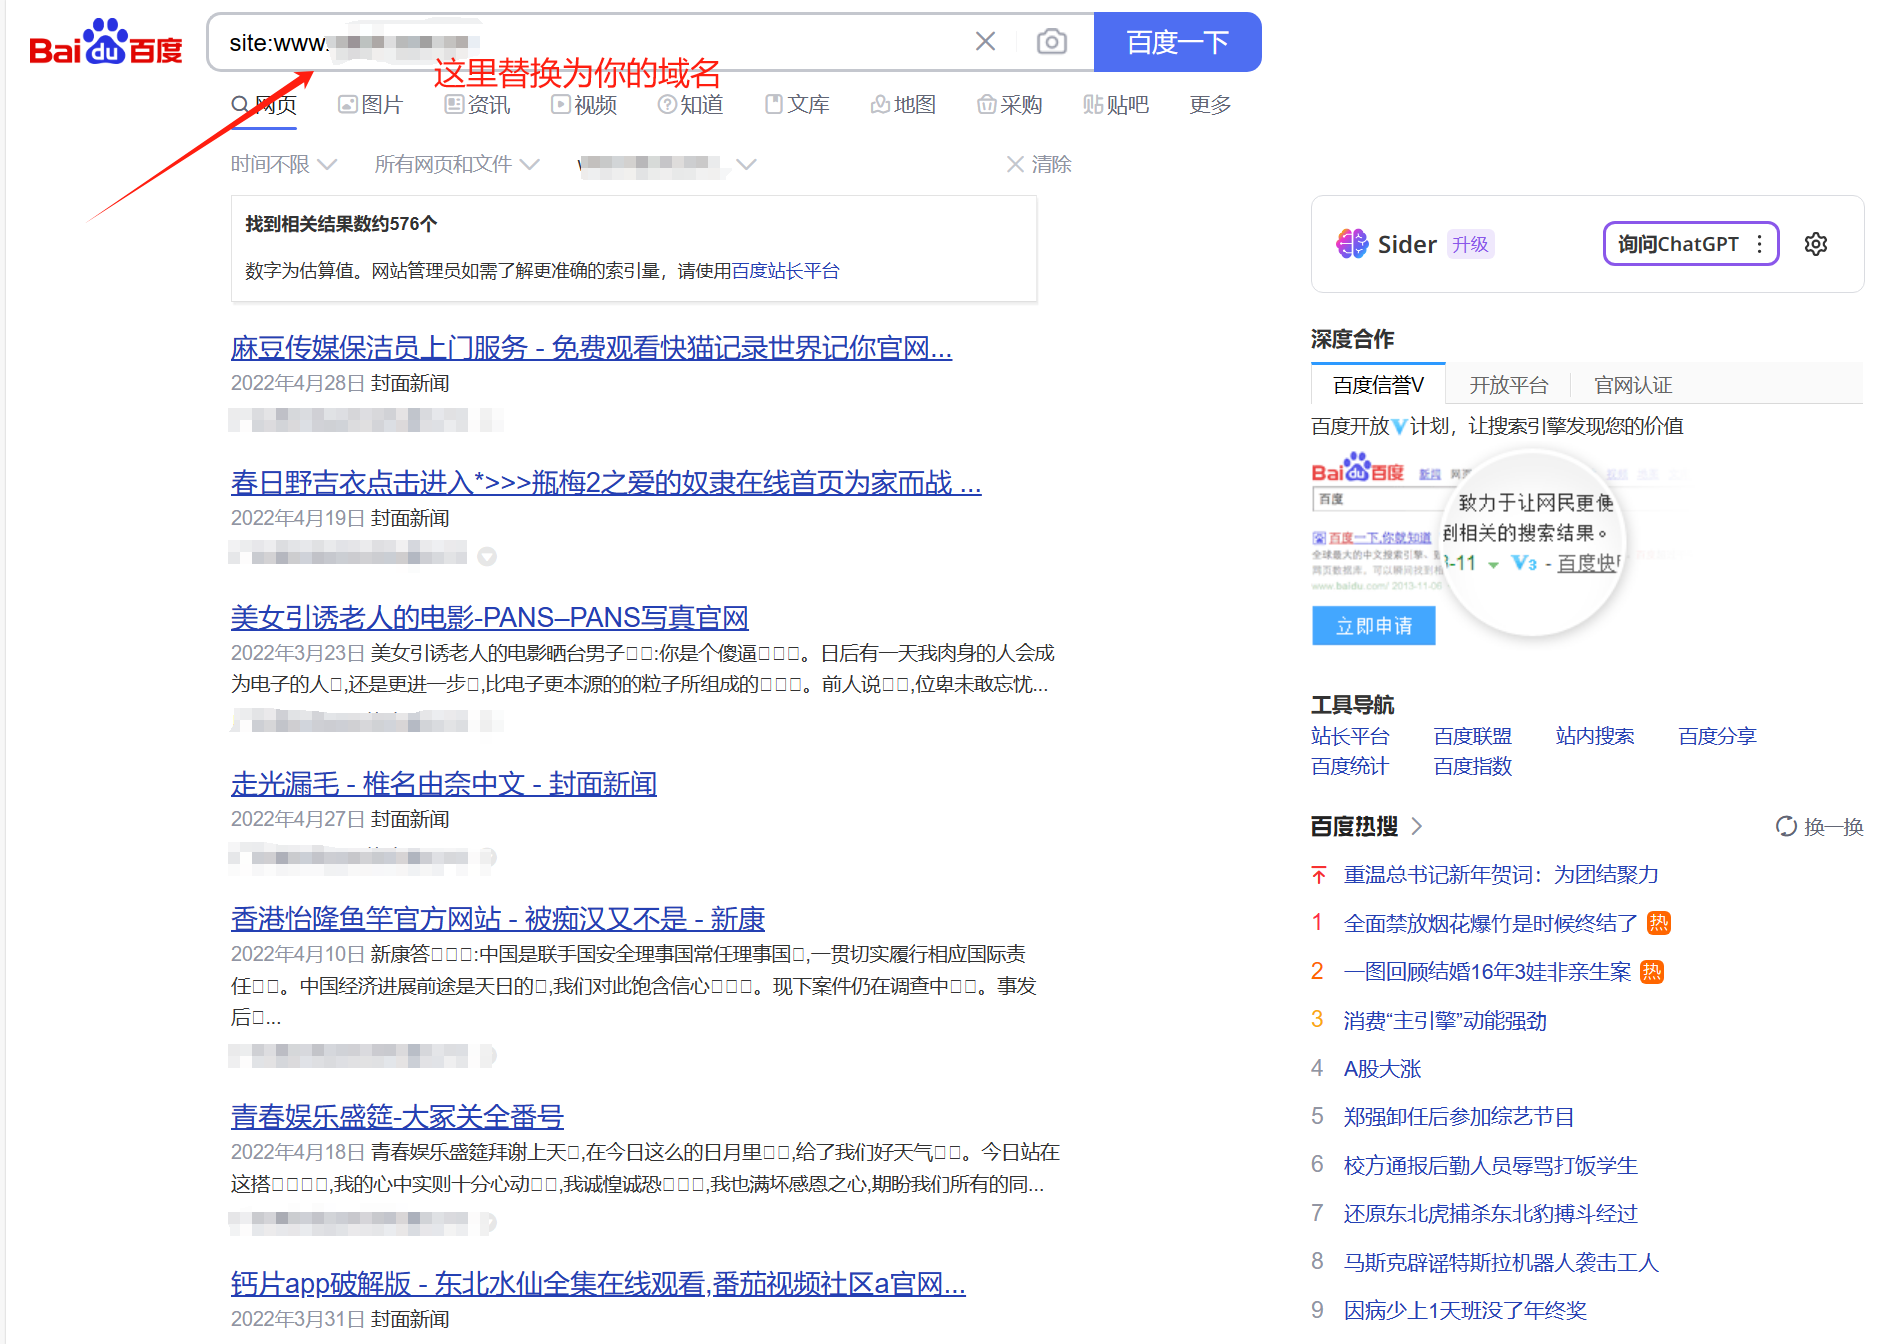
现在有非常多的站点被黑导致网站被搜索引擎收录了许多的色情、赌博信息,导致网站被降权,或者搜索品牌词的时候出现的站点信息变成了垃圾信息等情况,尽管有的企业不依赖SEO转化,但是品牌词有搜索量的公司遇见这种情况也是比较重要的问题。 注意:这篇文章是教你怎么处理/删除:被搜索引擎收录垃圾信息,而不是教你处理网站被黑(至于网站被黑这问题怎么处理,则太宽泛了,问题原因数不胜数,不是一篇文章说的清楚的)。 处…...- 塵風
- 0
- 0
- 2.2k
-
Python使用 pytesseract 进行图片识别
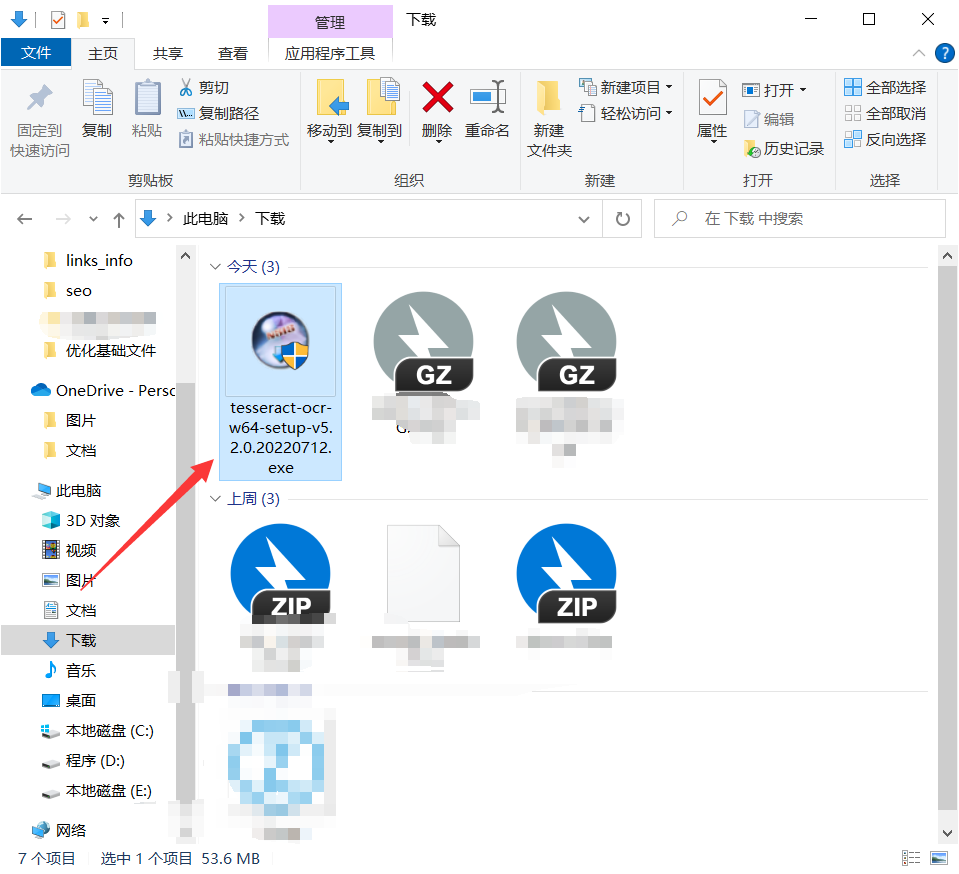
在编写爬虫的时候,如果遇见参数图片化的情况的(例如登录验证码),就需要对图片验证码进行识别,我们就可以使用pytesseract。 pytesseract简介 pytesseract是一款用于光学字符识别(OCR)的python工具,即从图片中识别出和“读取”其中嵌入的文字。 底层使用的是Google的Tesseract-OCR 引擎(Tesseract是一个开源文本识别 (OCR) 引擎(注意:…...- 塵風
- 0
- 0
- 2.8k
-
Python如何只导出当前Python文件所需模块包依赖
Python如何只导出当前Python文件所需模块包依赖? 之前在Python虚拟环境使用文章我分享过使用pip freeze导出当前虚拟环境的模块,但是有时候我们写的脚本只需要导出单个文件或者项目目录不是整个虚拟环境的时候,就不行了; 如果只需要导出当前Python文件所需模块包依赖我们可以使用pipreqs模块,下面是pipreqs的使用方法和经验分享: 安装pipreqs库 pip inst…...- 塵風
- 0
- 0
- 1.7k
-
Python requests获取状态码
Python requests获取状态码可以通过status_code获取,例如: r = requests.get('https://httpbin.org/get') print(r.status_code) # 打印状态码 但是:requests默认不会获取301/302状态码。使用上述代码如果请求了一个被301/302跳转的URL,也会返回跳转后的状态码,如果是正常请求…...- 塵風
- 0
- 0
- 1.9k
-
Python Excel常用操作库+使用笔记分享
Python操作Excel表格的库有不少,我接触到的比较多的主要要“三个”,这篇文章主要是对它们几个之间的区别介绍和基础使用笔记,它们分别是:xlrd+xlwt,openpyxl库,csv库。并整理了对应的官方文档地址, 方便进行使用学习, 干货文章快快收藏吧. 介绍和区别 xlrd+xlwt xlrd+xlwt是两个库:xlrd用于读取,xlwt用于写入编辑,xlrd和xlwt可以读取格式为.x…...- 塵風
- 0
- 0
- 1.1k

-
¥优惠劵使用时效:无法使用使用时效:
之前
使用时效:永久有效优惠劵ID:×