-
索引页链接补全机制的一种方法
背景 Spider位于搜索引擎数据流的最上游,负责将互联网上的资源采集到本地,提供给后续检索使用,是搜索引擎的最主要数据来源之一。spider系统的目标就是发现并抓取互联网中一切有价值的网页,为达到这个目标,首先就是发现有价值网页的链接,当前spider有多种链接发现机制来尽量快而全的发现资源链接,本文主要描述其中一种针对特定索引页的链接补全机制,并给出对这种特定类型的索引页面的建议处理规范用于优…... 塵風
- 0
- 0
- 1.1k
-
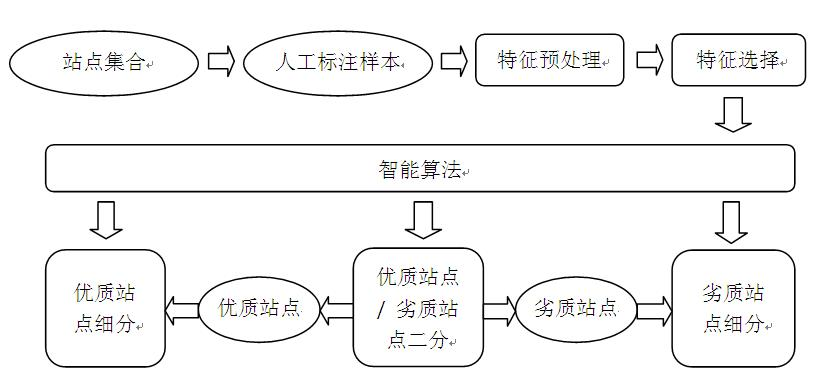
智能算法在站点质量评级体系中的应用
互联网的迅速发展,海量Web数据的扑面而来,给搜索引擎技术带来了严峻的挑战,但同时也带来了新的机遇。从网页抓取的角度来看,同一站点往往包含质量相似的资源,对一个优质网站进行爬取,往往可以找到更多的优质资源。因此,我们希望对网站的质量进行评级,来反映资源的质量水平,从而影响spider的调度和收录。在以往的实践中,大体思路是根据人工调研出的经验构造出规则和阈值。发现问题后逐个打补丁、调阈值,来适应变…...- 塵風
- 0
- 0
- 1.1k
-
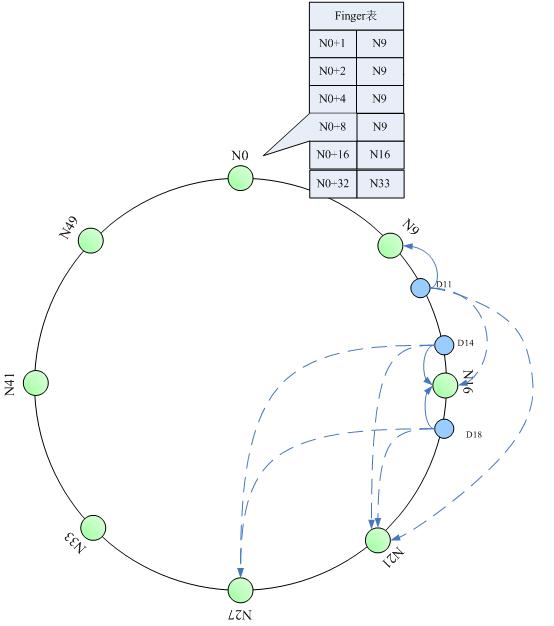
“分布式哈希”和“一致性哈希”的概念与算法实现
分布式哈希和一致性哈希是分布式存储和p2p网络中说的比较多的两个概念了。介绍的论文很多,这里做一个入门性质的介绍。 分布式哈希(DHT) 两个key point:每个节点只维护一部分路由;每个节点只存储一部分数据。从而实现整个网络中的寻址和存储。DHT只是一个概念,提出了这样一种网络模型。并且说明它是对分布式存储很有好处的。但具体怎么实现,并不是DHT的范畴。 一致性哈希: DHT的一…...- 塵風
- 0
- 0
- 1k
-

基于主特征空间相似度计算的切分算法及切分框架
我们为什么要切分? 说到切分(segmentation),大多数人最容易想到的就是中文分词。作为没有天然空格区分的语言,切词可以帮助计算机去索引文章,从而便于信息检索等方面。该部分主要用到了分词的一个方面:降低搜索引擎的性能消耗。我们常用的汉字有5000多个,常用词组是几十万个。在倒排索引中,如果用每个字做索引的话,那么会造成每个字对应的拉链非常长。所以我们一般会用词组来代替单个汉字建立索引。除此…...- 塵風
- 0
- 0
- 1k
-
相似度计算常用方法综述
引言 相似度计算用于衡量对象之间的相似程度,在数据挖掘、自然语言处理中是一个基础性计算。其中的关键技术主要是两个部分,对象的特征表示,特征集合之间的相似关系。在信息检索、网页判重、推荐系统等,都涉及到对象之间或者对象和对象集合的相似性的计算。而针对不同的应用场景,受限于数据规模、时空开销等的限制,相似度计算方法的选择又会有所…...- 塵風
- 0
- 0
- 1.6k
分类描述:
百度搜索研发部官方原介绍:百度搜索研发部官方博客(http://www.baidu-tech.com)由百度搜索研发部创建并维护。我们希望通过网络社区与关注搜索引擎及相关产品的技术人员交流互动,分享百度工程师研究的方向和取得的成果。
注:后貌似在2013年底关停。故而我在互联网中收集整理出部分和搜索引擎相关的内容转发出来,供大家查看。
这些内容对我们了解搜索引擎应该是极具价值的,尤其是当年(那时候我还没接触SEO呢),不过毕竟是时间很长的文章了,现在部分内容在百度资源平台的一些文档中也有提及。

-
¥优惠劵使用时效:无法使用使用时效:
之前
使用时效:永久有效优惠劵ID:×